Red Lizard Studioz
Plataforma multi-tenant de contenido con IA y venta conversacional
- Rol
- Full-stack Engineer
- Tipo de trabajo
- Colaboración con equipo
- Industria
- Tecnología de marketing • SaaS para agencias
Resumen
El desafío
Enlaces
Privado — proyecto de cliente
Arquitectura del sistema
La plataforma está construida como dos aplicaciones desplegadas sobre un modelo de tenants compartido: un backend en Strapi 5 que es dueño de los datos, de los pipelines de IA y de 116 endpoints propios, y un dashboard en Next.js 15 que funciona a la vez como consola de operación y como renderizador de los storefronts públicos. La decisión clave fue tratar a Strapi como un framework de aplicación y no como un CMS: los content types definen el modelo de datos acotado por tenant, mientras que el comportamiento vive en unas 25.000 líneas de servicios propios que cubren generación, retrieval, agentes, compliance y diseño.
Arquitectura de la aplicación
- Backend en Strapi 5 con 39 content types y 116 endpoints REST propios, más dos plugins dentro del repositorio.
- Frontend en Next.js 15 App Router que sirve el dashboard de operación, los storefronts públicos de cada tenant y 72 rutas de API del lado del servidor que hacen de proxy hacia Strapi con autorización por ruta.
- Patrón de proxy autenticado same-origin, más un proxy SSE dedicado para la generación en streaming.
- Protocolo AG-UI sobre server-sent events para el runtime de agentes, de modo que el streaming, las tool calls y los eventos de ciclo de vida siguen un contrato publicado.
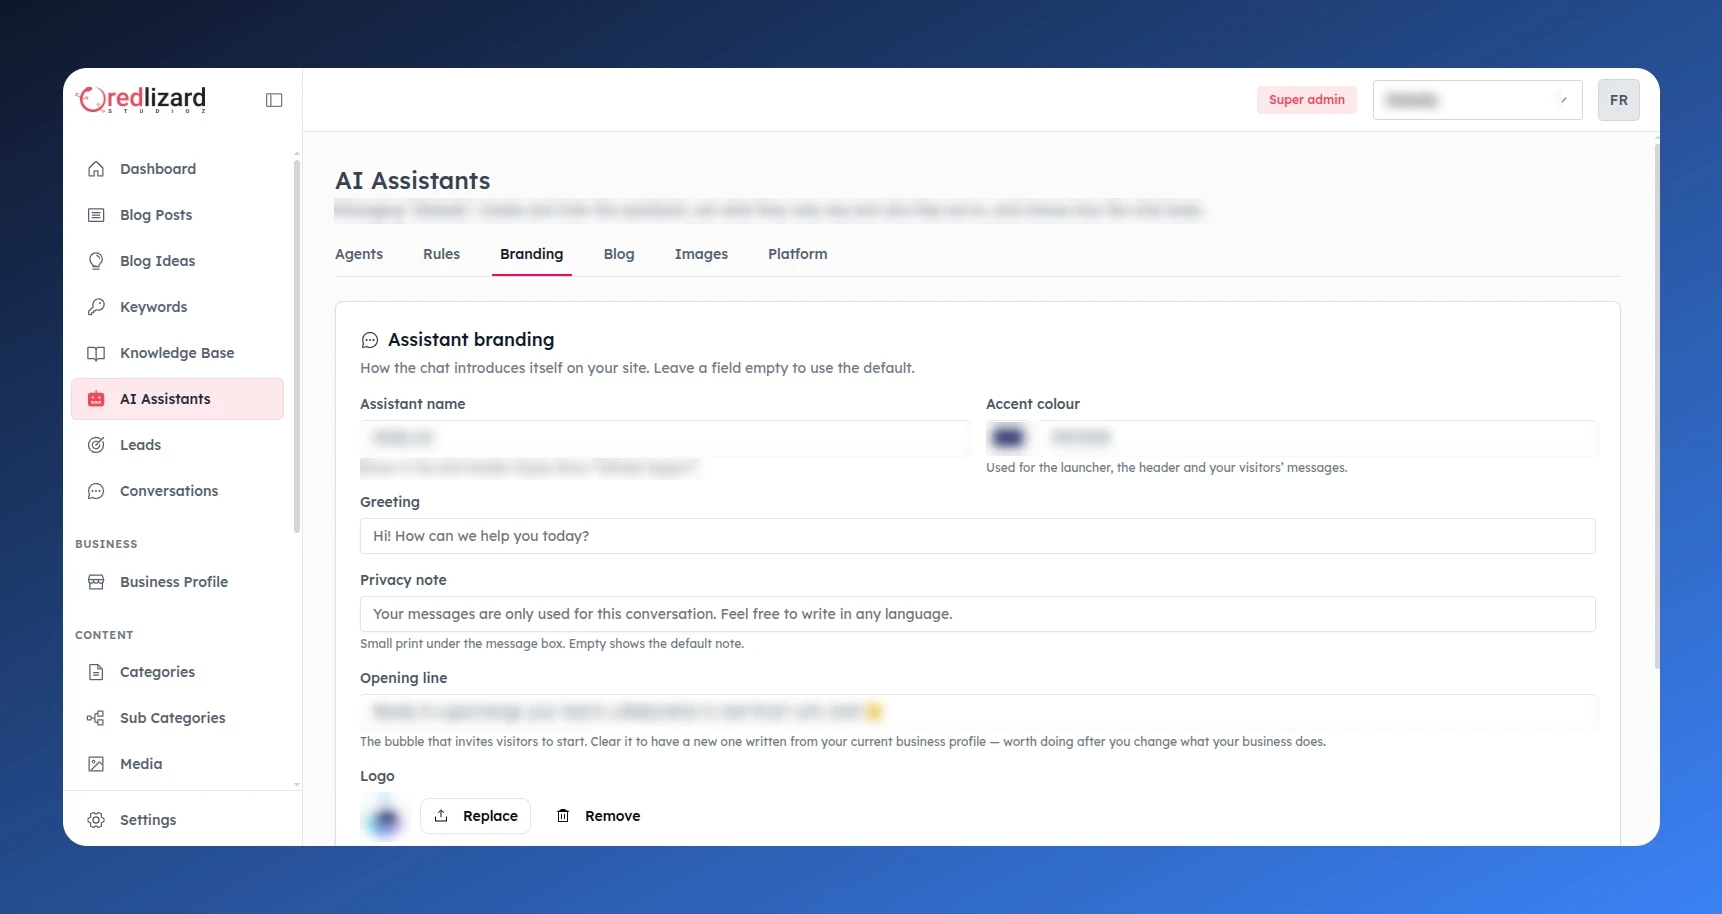
- Un widget embebible montado en Shadow DOM, servido desde el backend e instalable en cualquier sitio externo con un script tag de una sola línea.
Funcionalidades de la plataforma
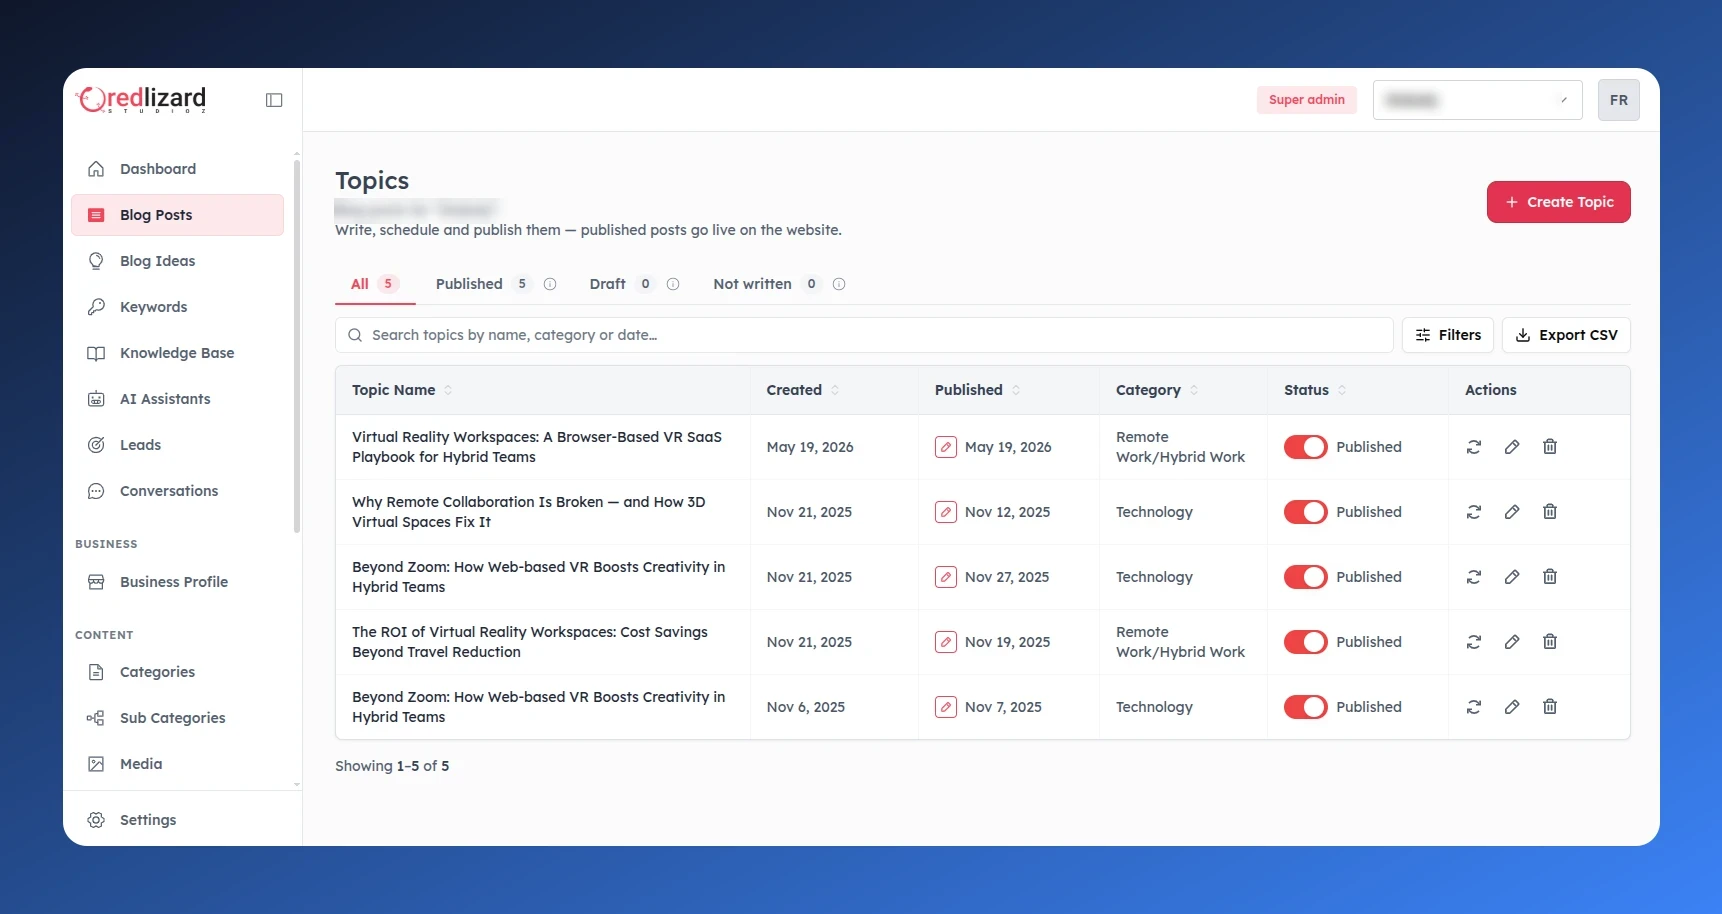
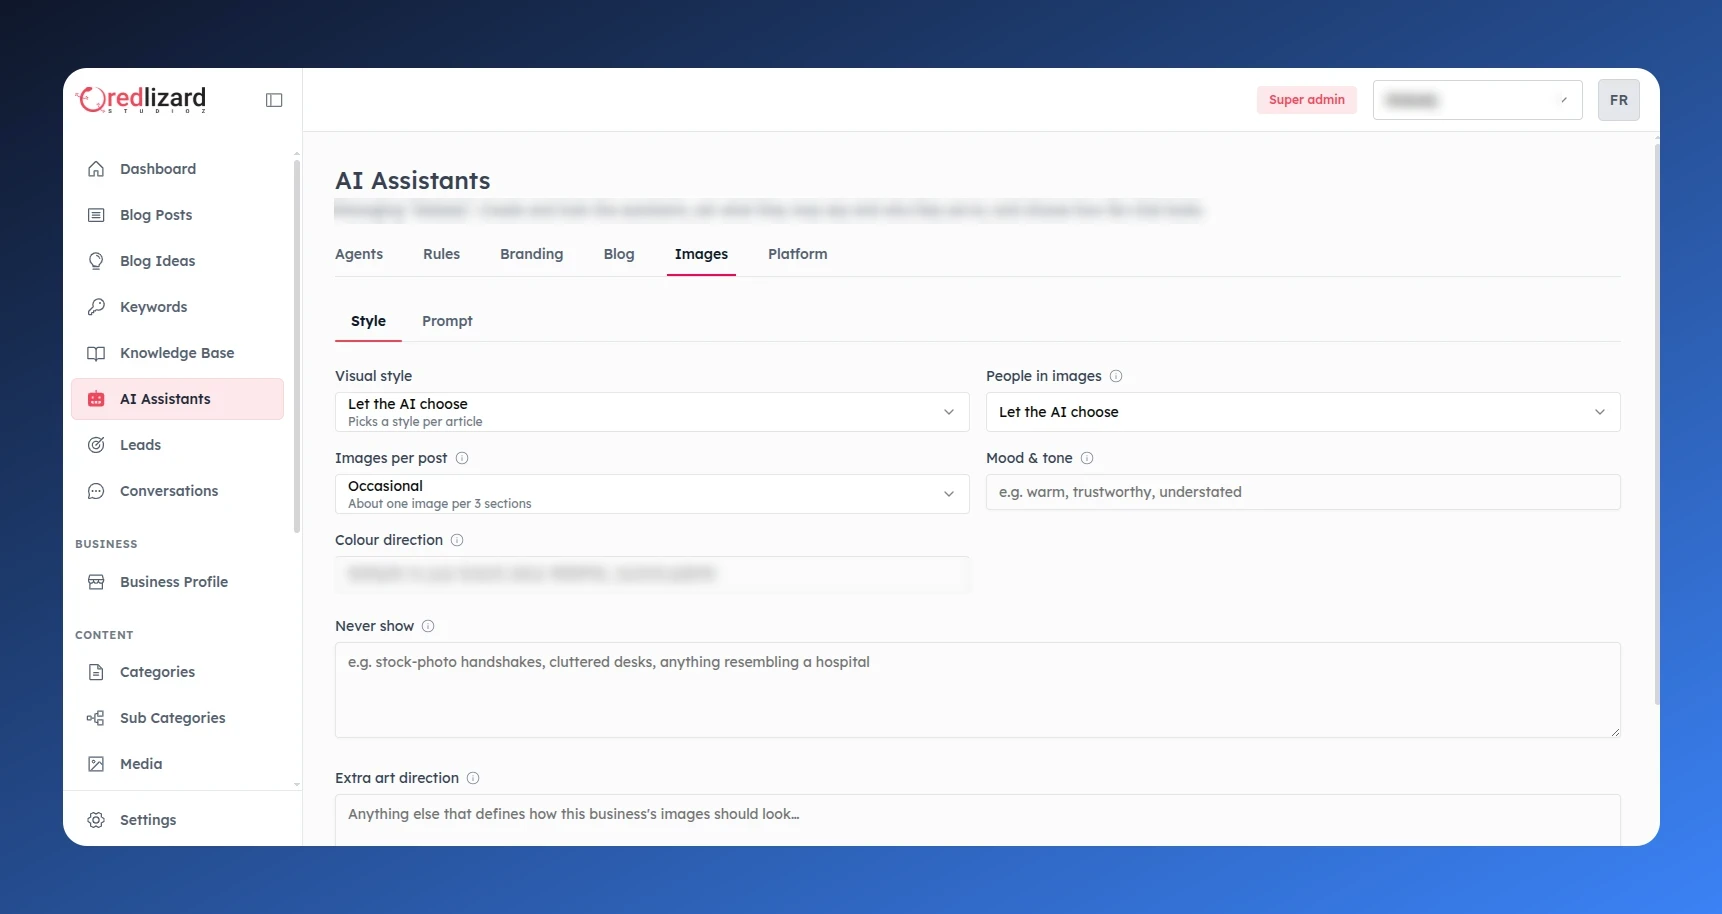
- Pipeline de artículos en varias etapas: outline, borrador, revisión editorial, revisión condicional, imagen de portada con la marca y publicación programada.
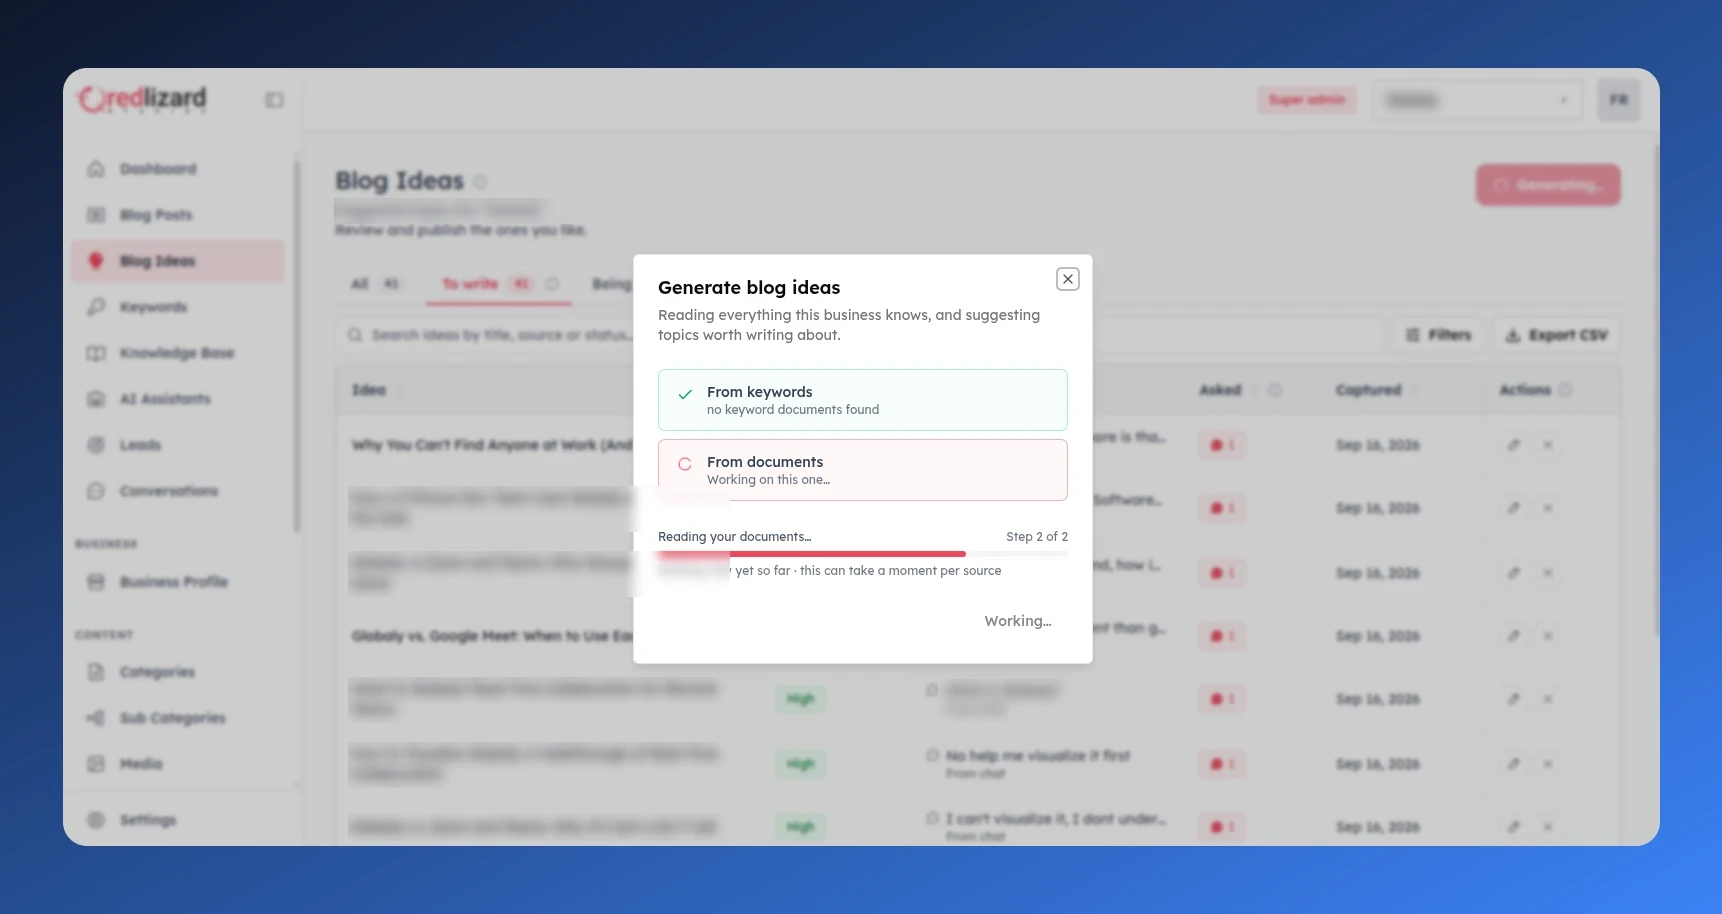
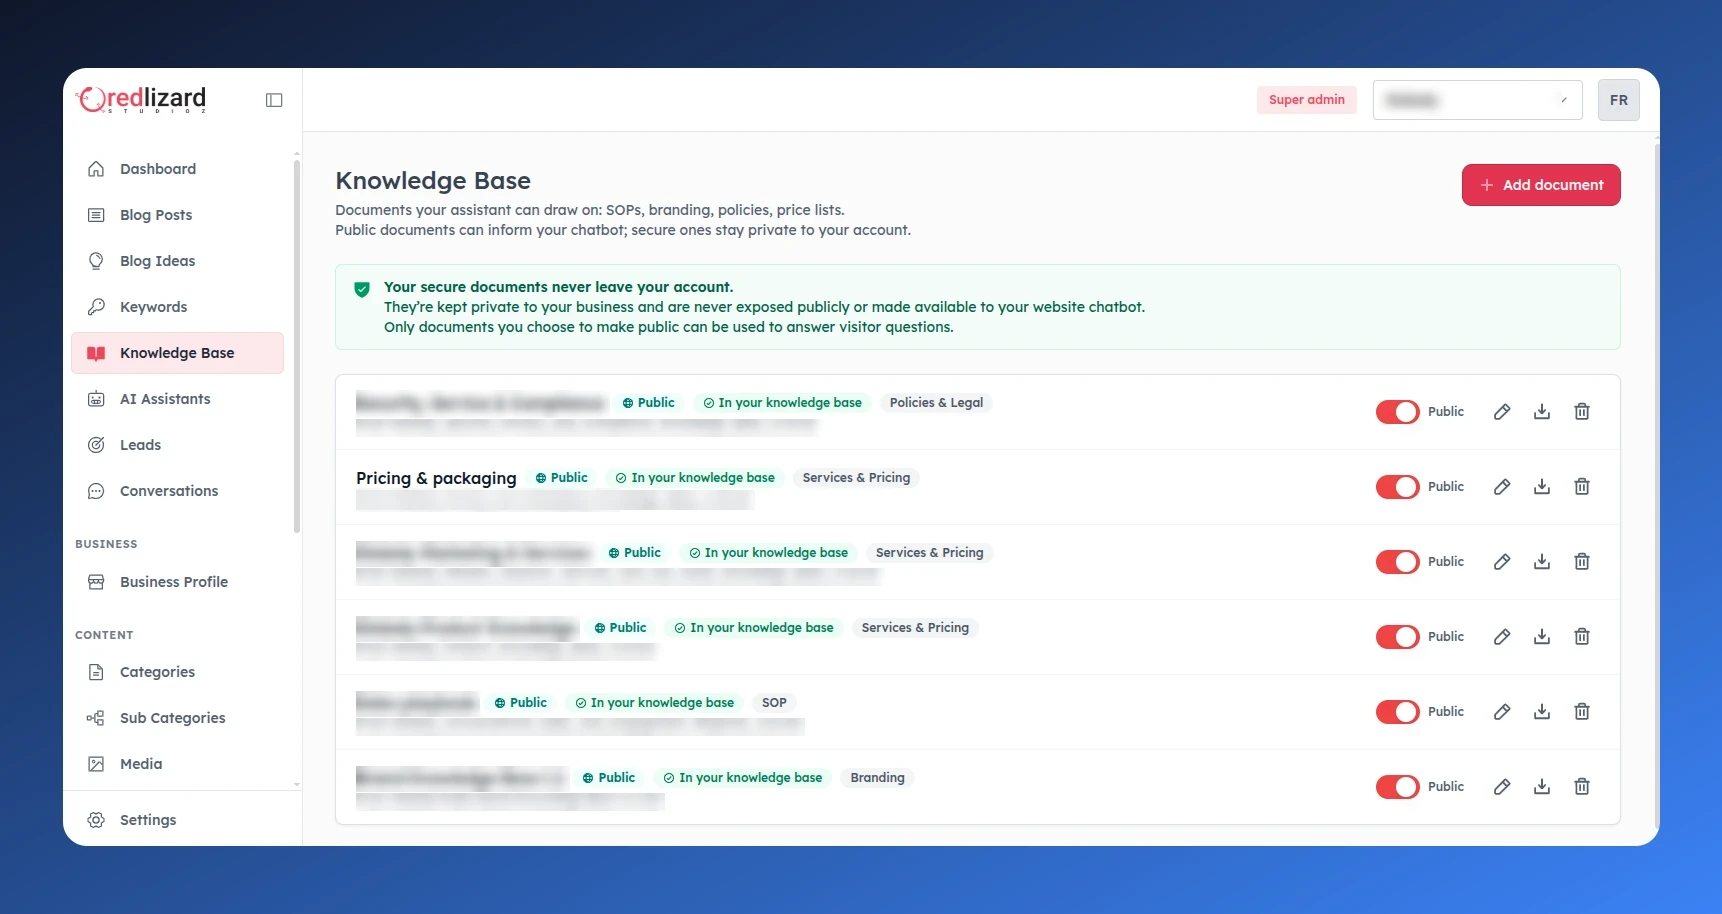
- RAG por tenant sobre documentos subidos, servicios, FAQs, perfil del negocio y URLs de sitios web ingestadas.
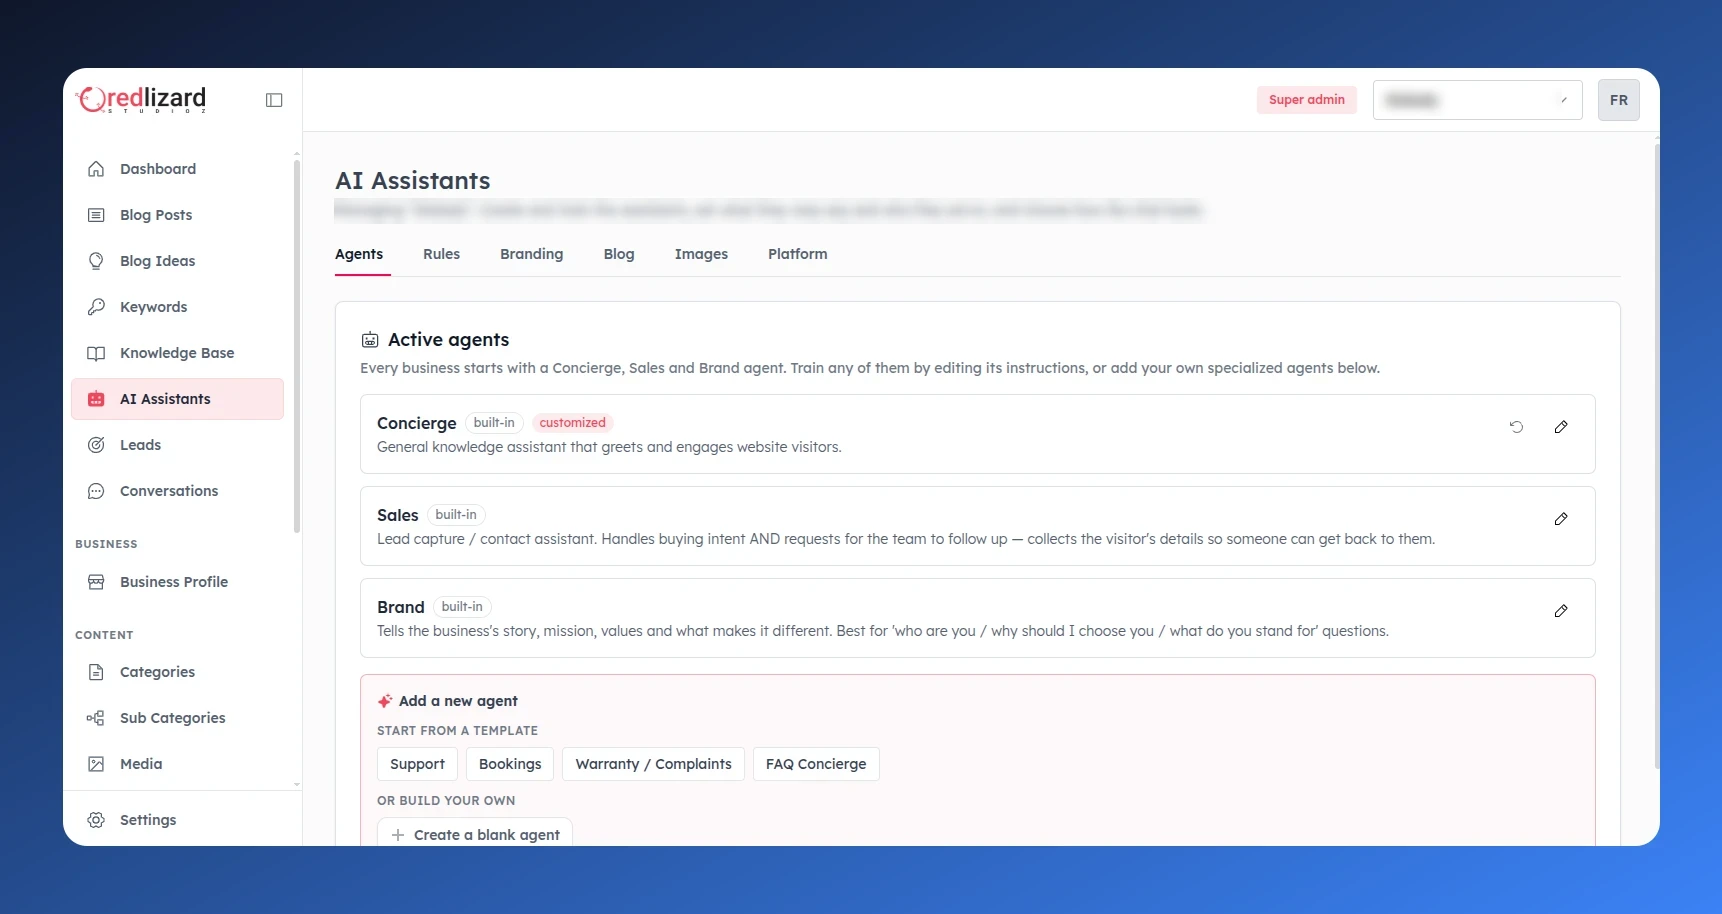
- Agentes de chat con autorización de herramientas por llamada, captura de leads y una red de seguridad que rescata los datos de contacto que el modelo no llegó a guardar.
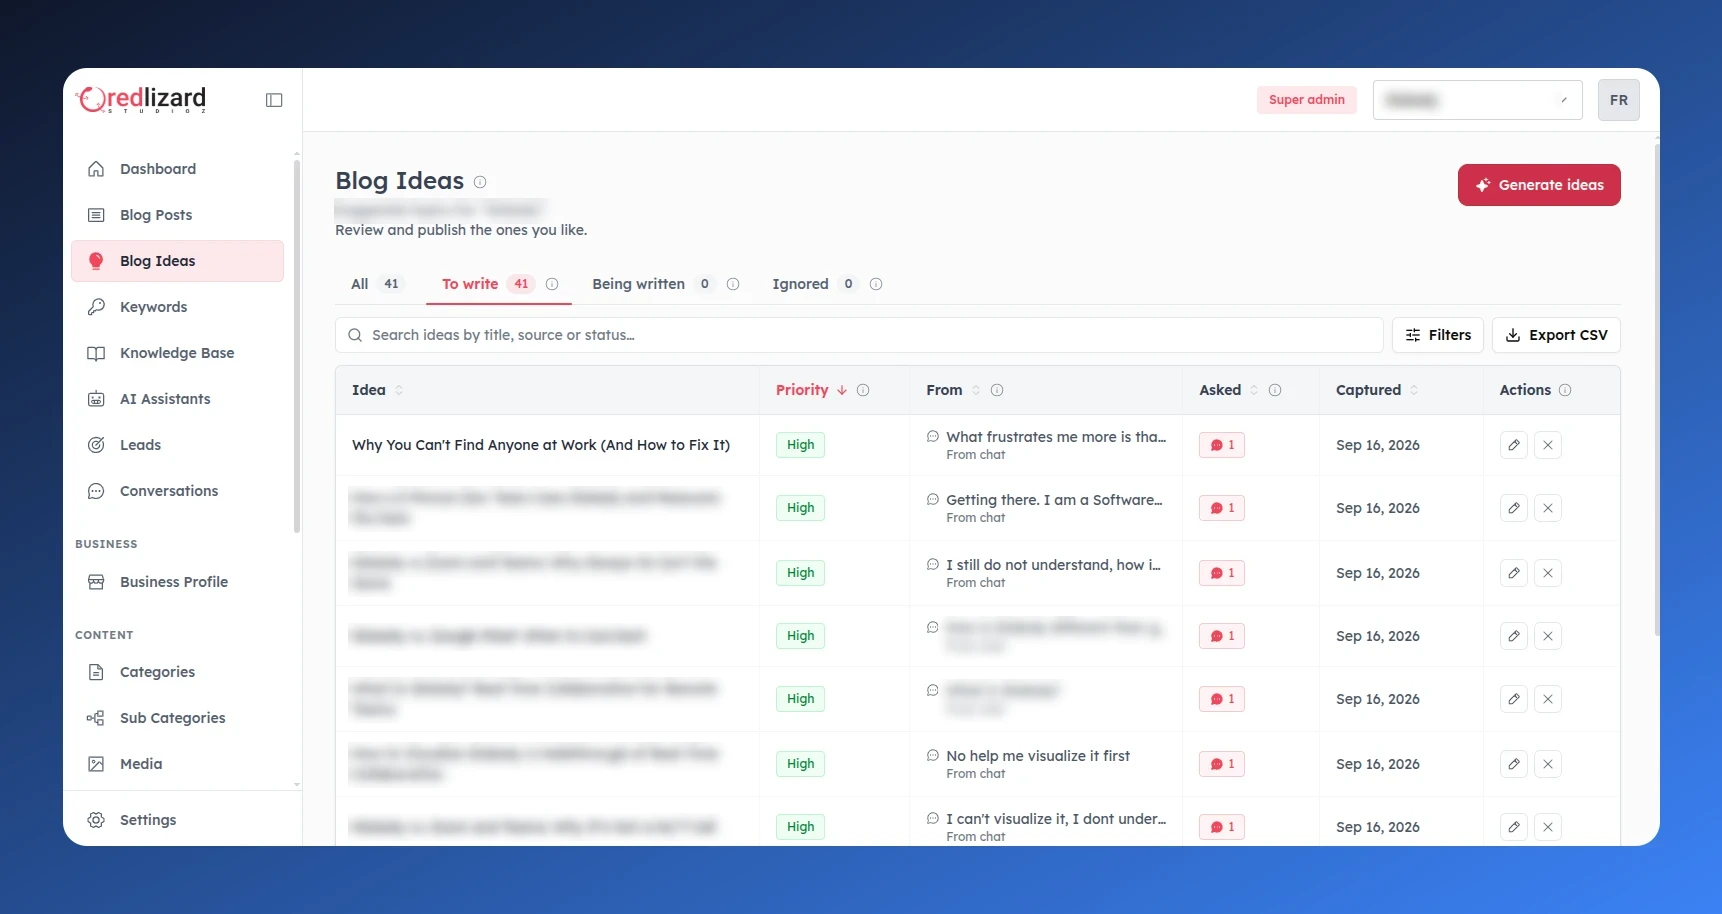
- Detección de huecos de conocimiento que convierte las preguntas de visitantes sin respuesta en ideas de blog puntuadas.
- Pipeline multi-agente de diseño de sitios web con caché por etapa, degradación elegante y reporte de progreso en vivo.
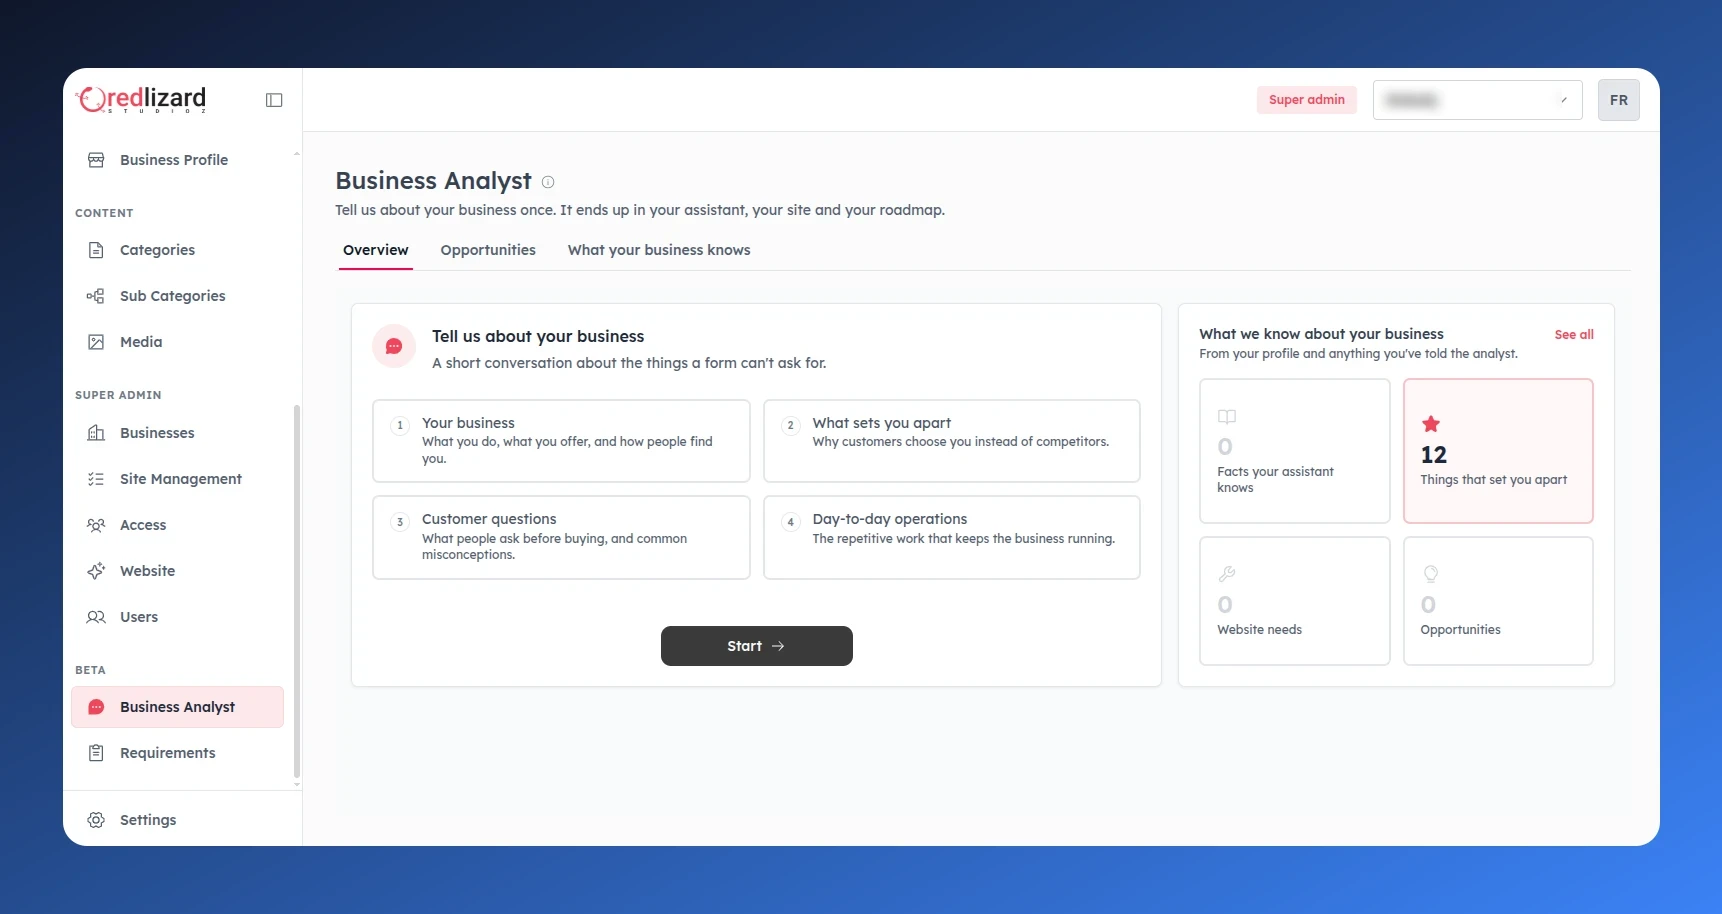
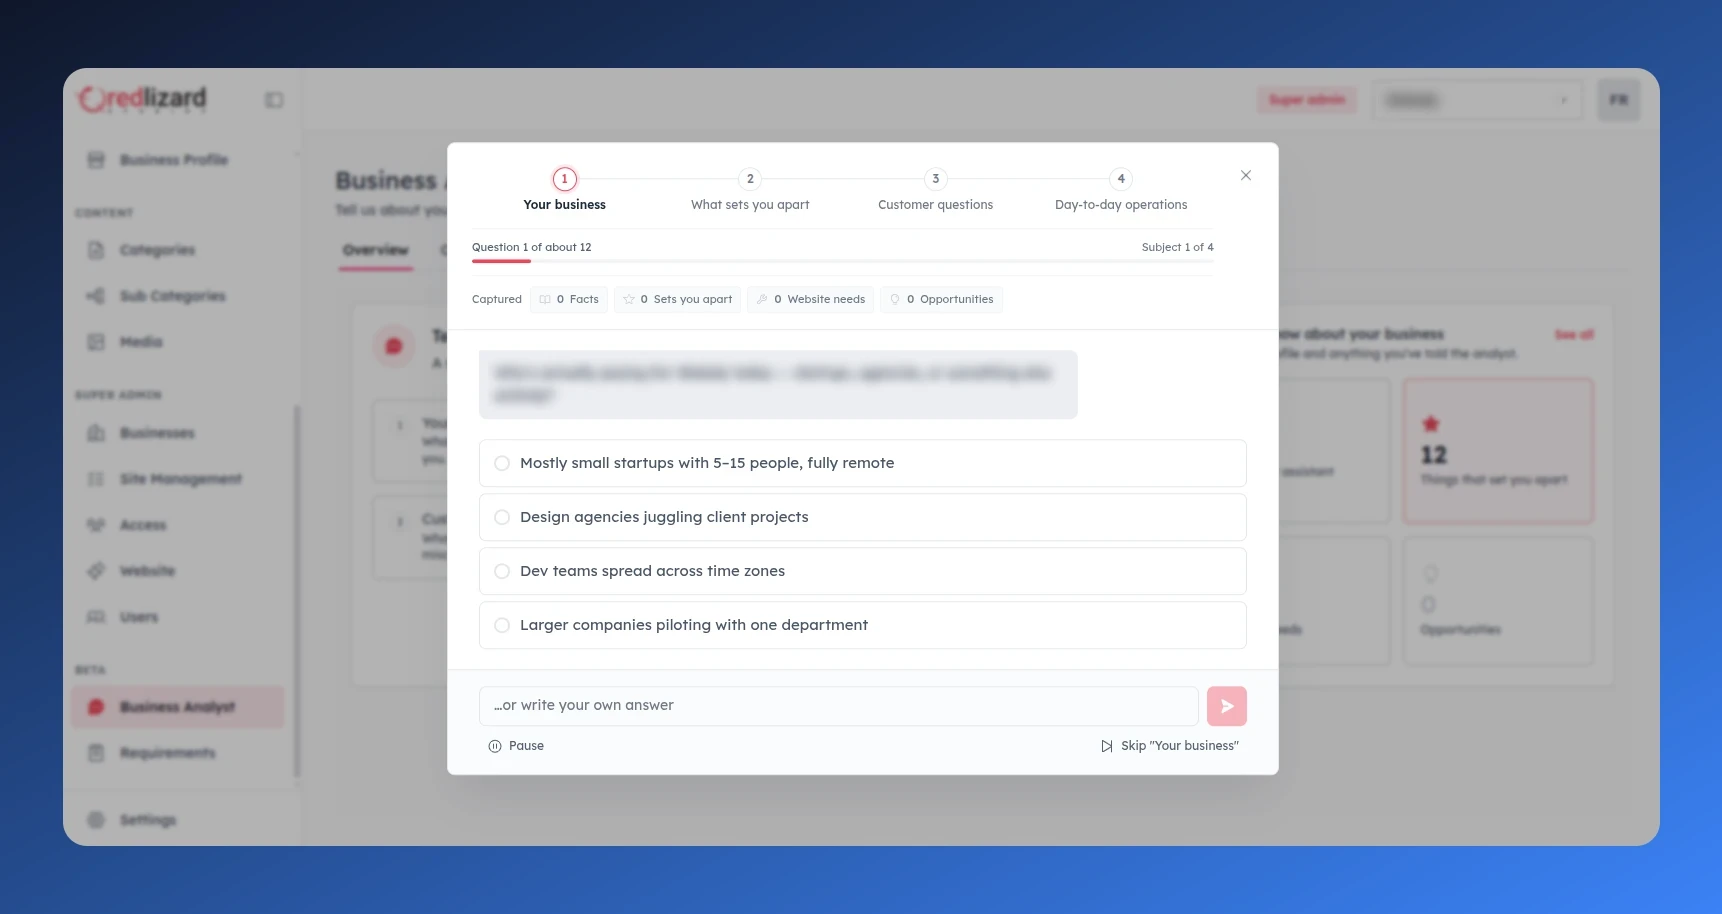
- Entrevistas conversacionales que completan el perfil del negocio, incluido un flujo por link de invitación para quienes responden sin tener cuenta.
Modelo de datos
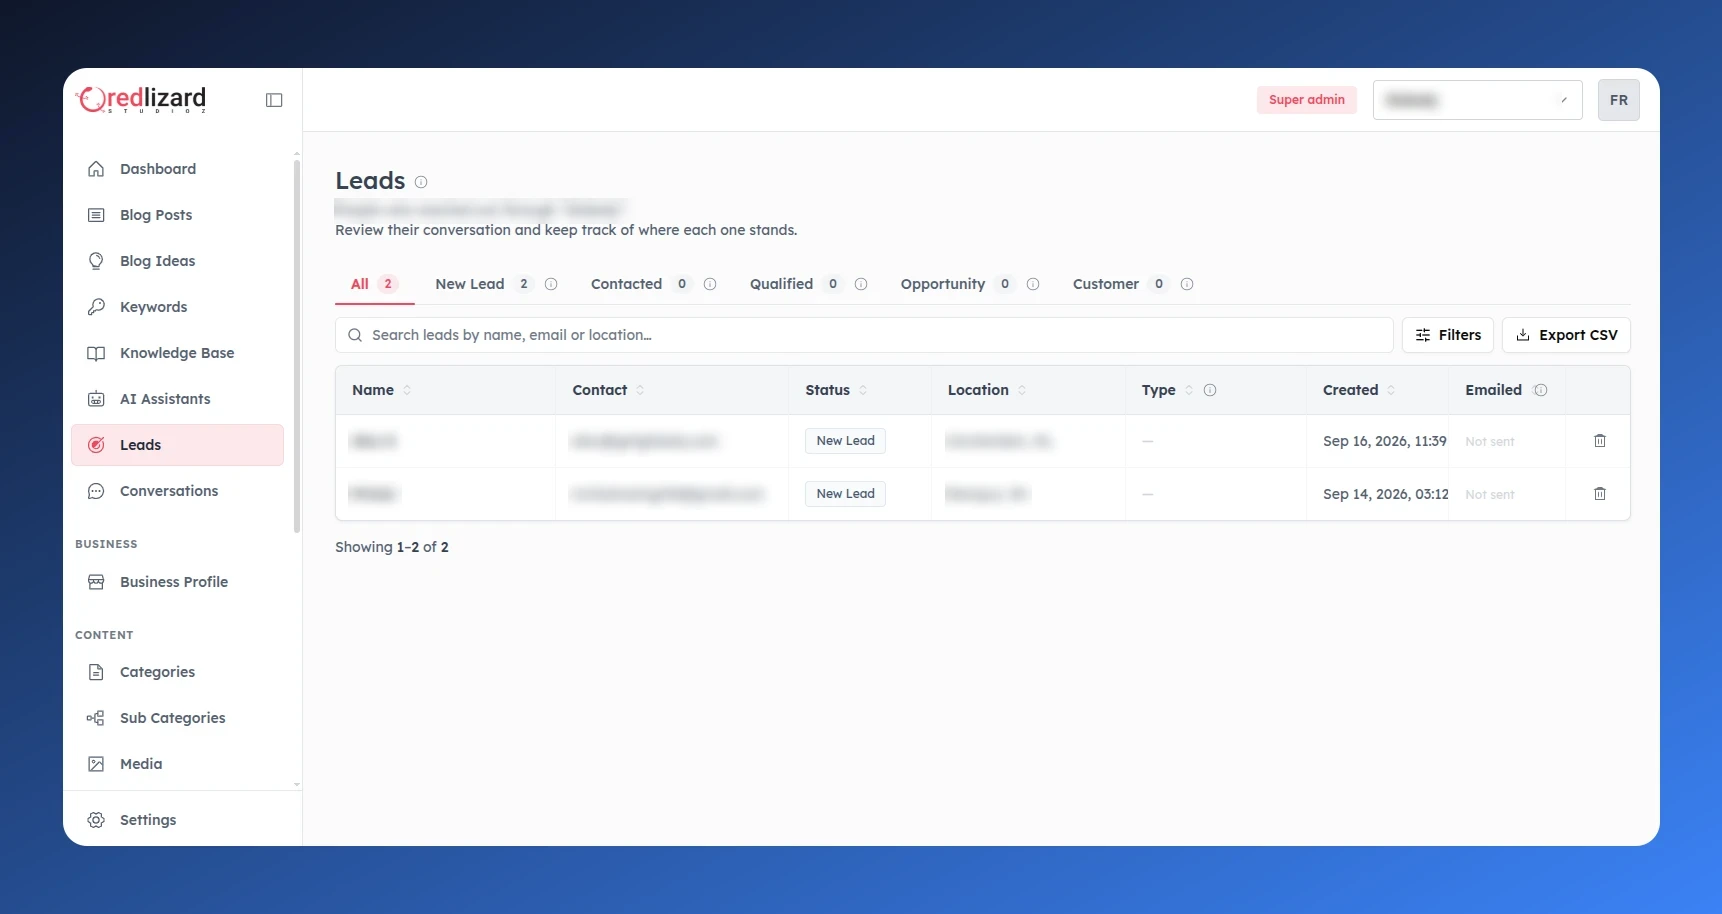
- Una entidad de proyecto como raíz del tenant, relacionada con artículos, documentos de conocimiento, keywords, leads, conversaciones, servicios, testimonios, FAQs, páginas del sitio y registros de diseño.
- Componentes reutilizables para la configuración de cada tenant: config de LLM, reglas de compliance, config del widget, tema, identidad, contacto, agente de imágenes e inteligencia comercial.
- Documentos de conocimiento con un enum de visibilidad público/seguro que por defecto es seguro.
- Conversaciones modeladas con intención, sentimiento, resultado, preguntas sin responder y atribución de dispositivo; leads con un ciclo de vida completo que incluye estado, subestado y resúmenes generados.
- Overrides de prompts como filas de primera clase, con scope y una relación opcional a proyecto, donde un proyecto null representa el valor global por defecto.
Autenticación
La identidad abarca tanto al staff de la agencia, que trabaja sobre todos los tenants, como a los clientes, acotados a un solo negocio.
- Strapi JWT
- Google OAuth
- Grupos de roles
- Asignación de tenant
- Secreto compartido interno
- Política fail-closed
- Rutas sólo para owners
Infraestructura y deploy
Ambas aplicaciones se distribuyen como imágenes Docker construidas exclusivamente en runners de CI y descargadas por los servidores, una política adoptada después de que un build in situ agotara la memoria de un host de producción compartido. El despliegue es un pipeline de Bitbucket que corre la suite de tests en cada pull request y en cada push a una rama, buildea contra una caché de BuildKit en el registry y ejecuta por SSH un script de deploy en la máquina de destino.
Hosting y despliegue
- Host en Linode detrás de Cloudflare, con TLS terminando en el proxy y la aplicación configurada para confiar en el proxy.
- Imágenes separadas de dev y producción a partir de Dockerfiles distintos, fijadas a versiones mayores de Node diferentes por razones de dependencias documentadas.
- Output standalone de Next.js corriendo con un usuario no root, con limpieza de imágenes post-deploy que conserva los tres tags más recientes.
CI/CD
- Los tests corren en cada pull request y en cada push a una rama; una suite en rojo bloquea el build y el deploy.
- La suite del backend es offline por diseño —sin key, sin base de datos, sin red—, y los tests que llaman al modelo son opcionales detrás de un flag --live.
- Builds de BuildKit con caché en el registry, tags por SHA de commit y por rama, y lógica de reintento ante race conditions en el push al registry.
- Build args específicos por rama para que cada entorno incorpore su propia URL de backend, después de que una constante de build-time hiciera que un deploy de dev apuntara a producción.
Datos y almacenamiento
- Dos instancias de PostgreSQL 17: la base de datos de la aplicación y una instancia con pgvector para embeddings, esta última sin exponer al host en producción.
- Migraciones SQL para el esquema vectorial, incluida la columna de visibilidad y una función de similitud filtrada por visibilidad.
- Connection pooling configurado por entorno; rotación de logs de contenedores después de que un log sin límite llegara a cientos de megabytes.
Operaciones
- Tres jobs programados: generación de artículos cada hora, publicación programada cada cinco minutos con un guard de abandono y un resumen diario configurable con soporte de zonas horarias.
- Healthcheck en el contenedor del frontend, con límites y reservas de memoria en todos los servicios.
- Secretos provistos mediante variables de CI y validados como no vacíos antes de usarse, después de que un argumento vacío desplazara una lista posicional entera.
Construido con
Entregado como un sistema funcional de dos aplicaciones, con consola de operación, storefronts públicos por tenant, un widget embebible y los pipelines de IA que los sostienen.
Superficies de la aplicación
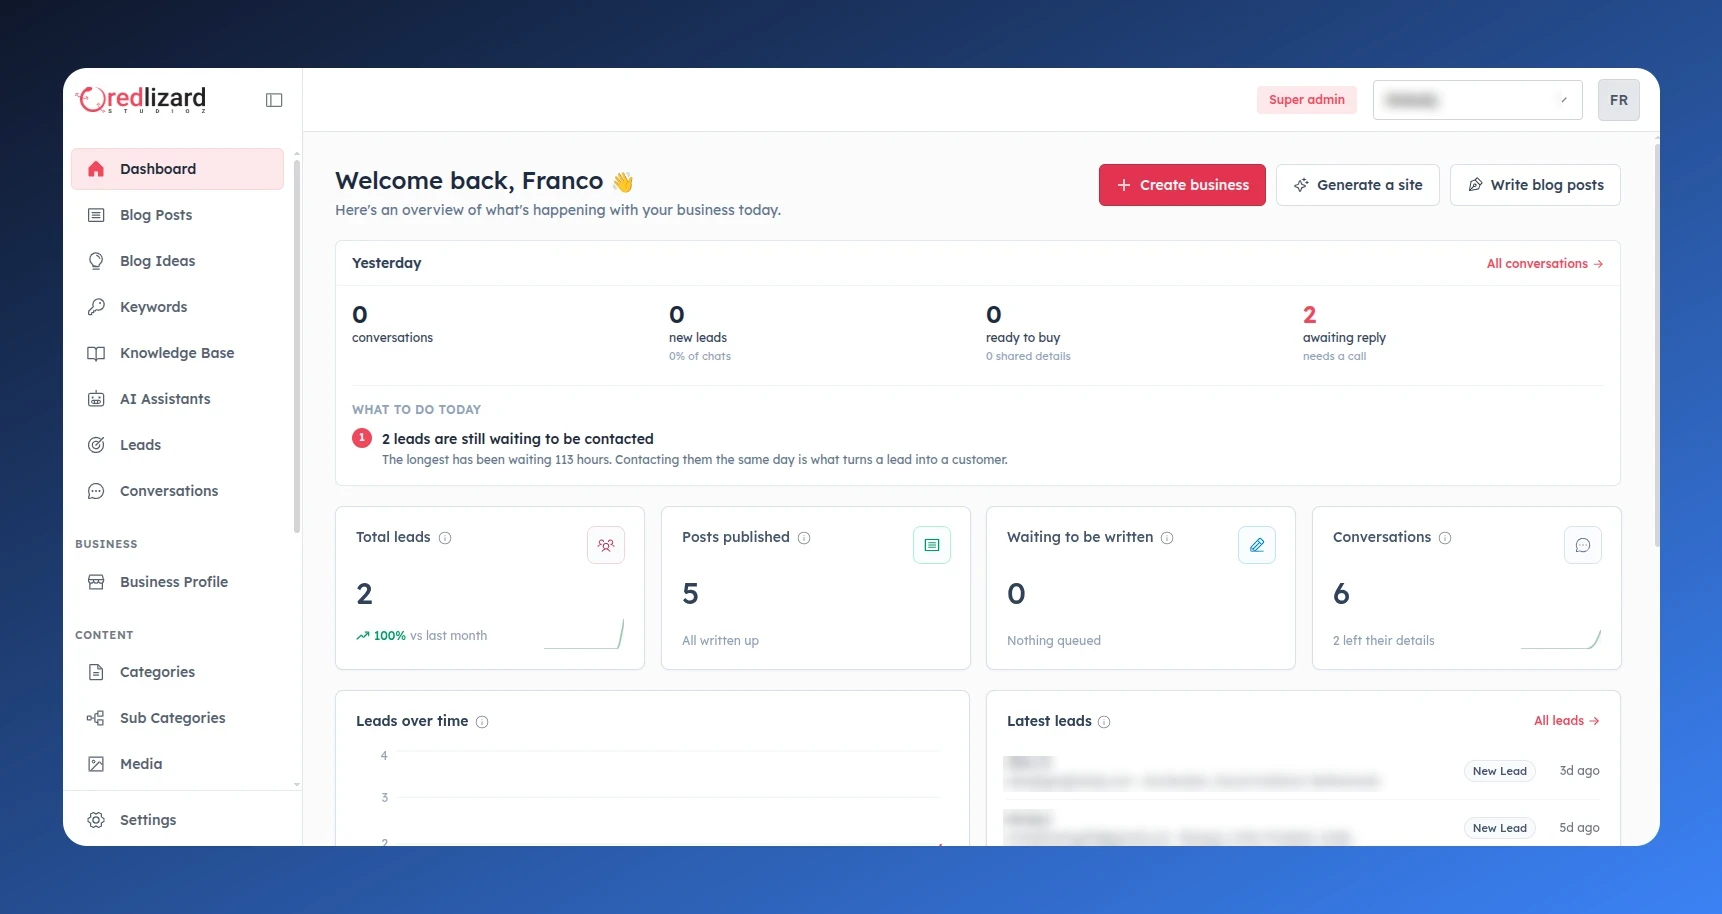
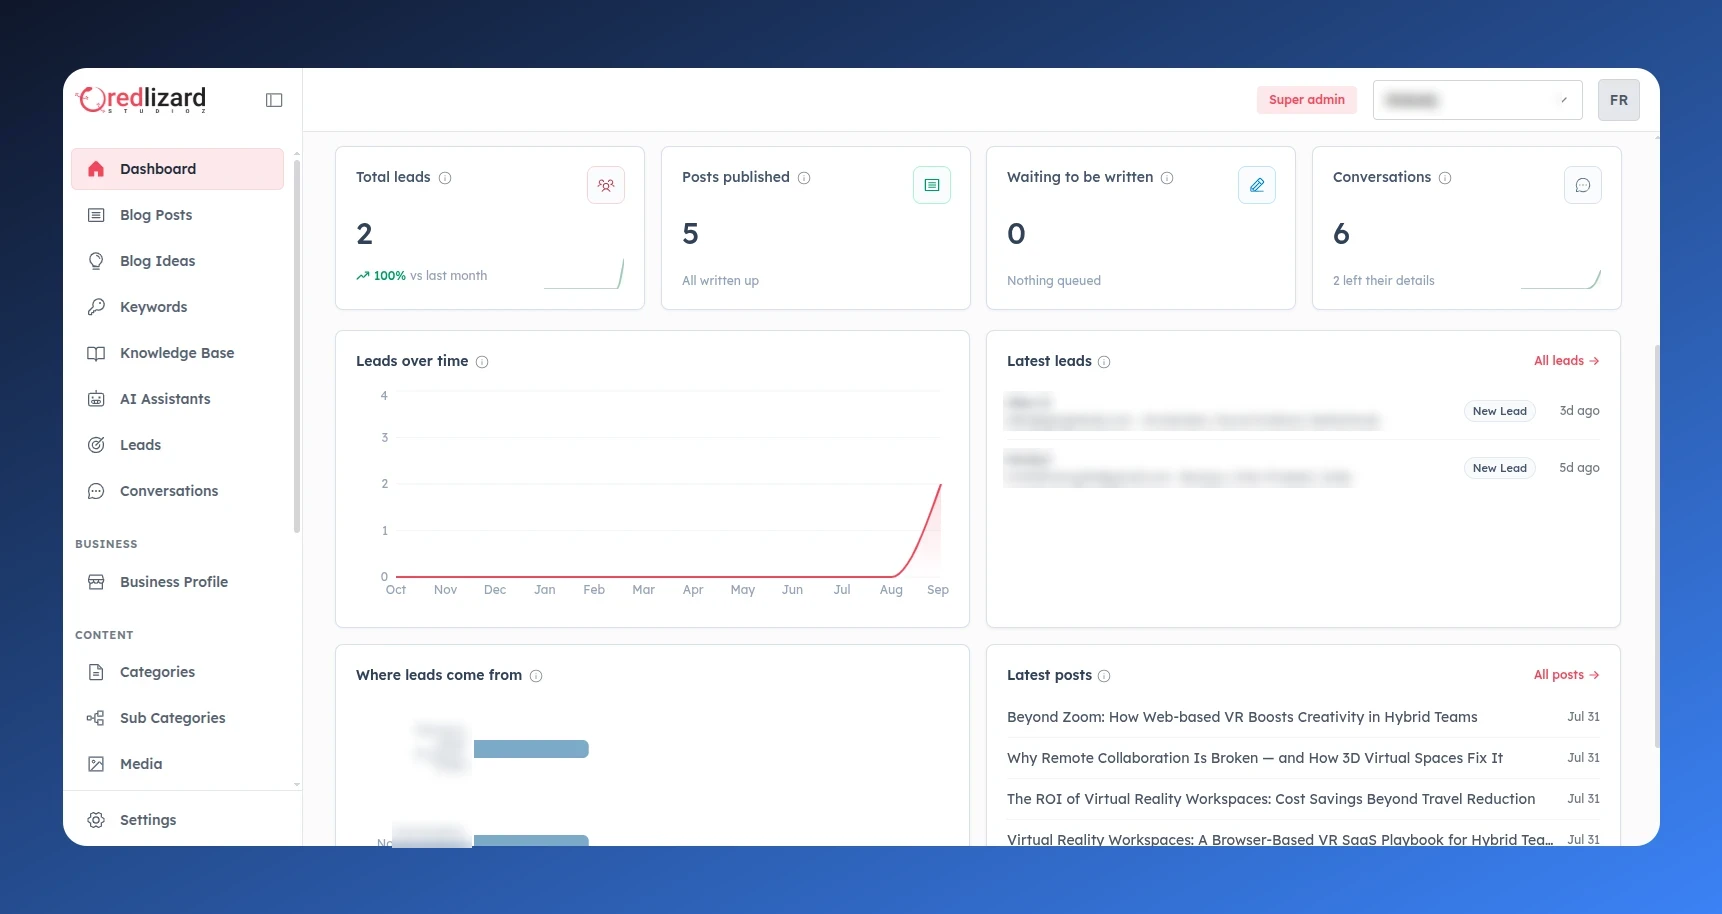
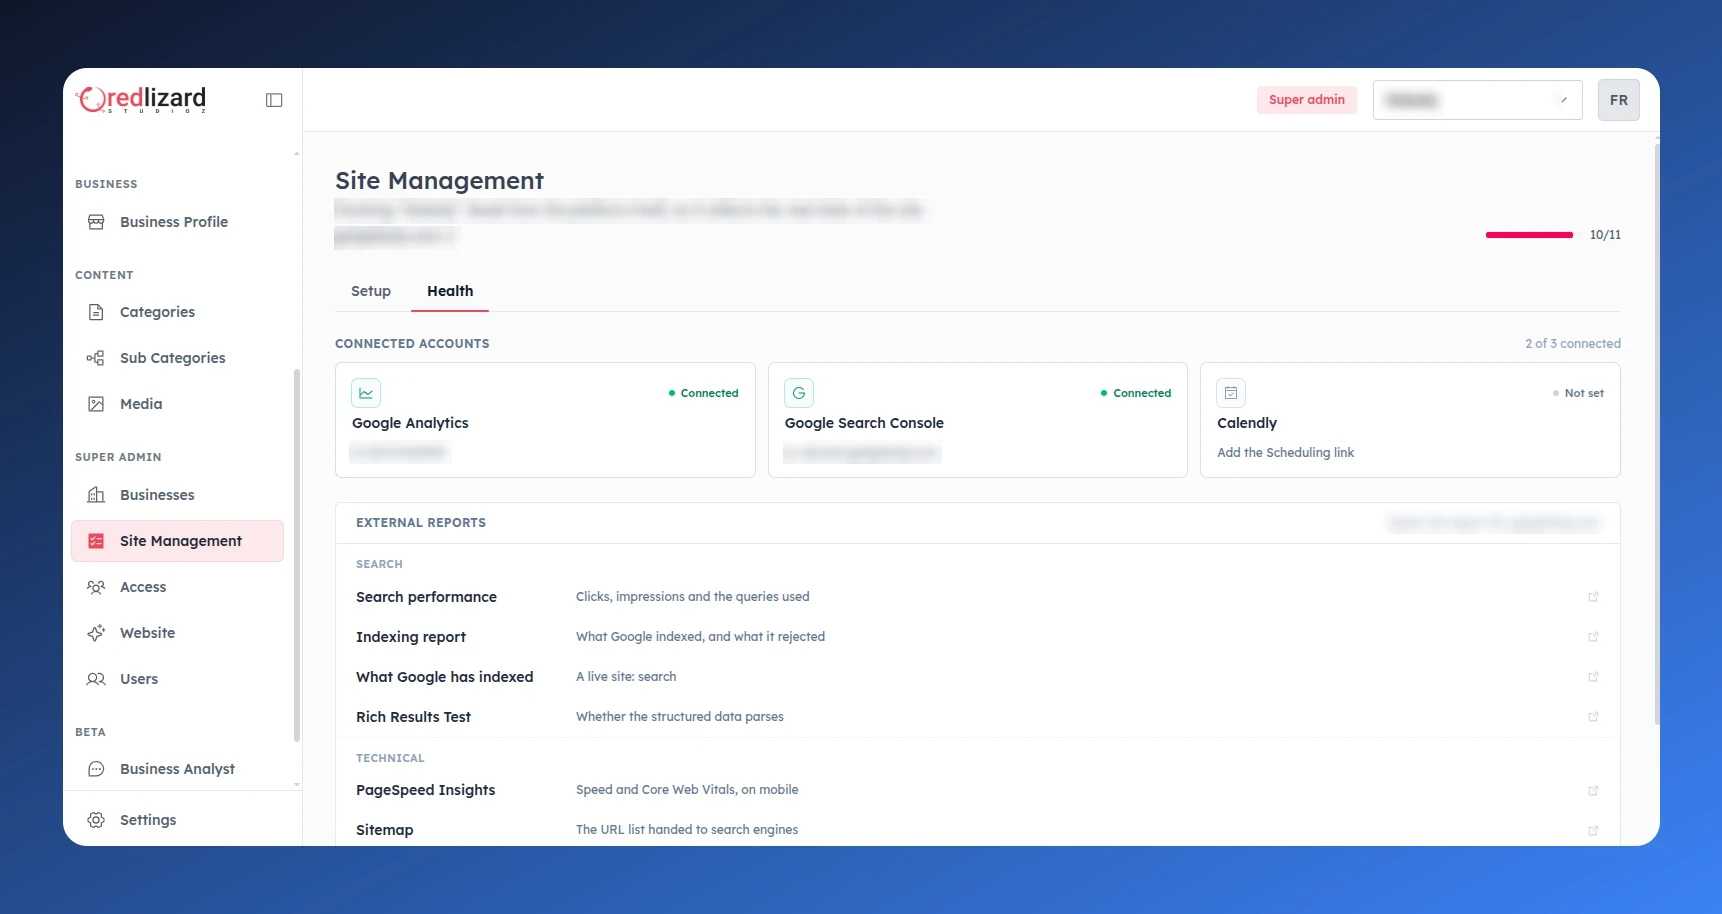
- Un dashboard de operación con 24 secciones que abarcan contenido, negocio, super-admin y áreas beta.
- Design Studio: un editor de diseño web con IA a pantalla completa, con paneles de brief, plan, canvas, secciones, versiones, competidores y referencias.
- Storefronts públicos por tenant con ruteo por tenant, soporte de dominios propios y revalidación incremental.
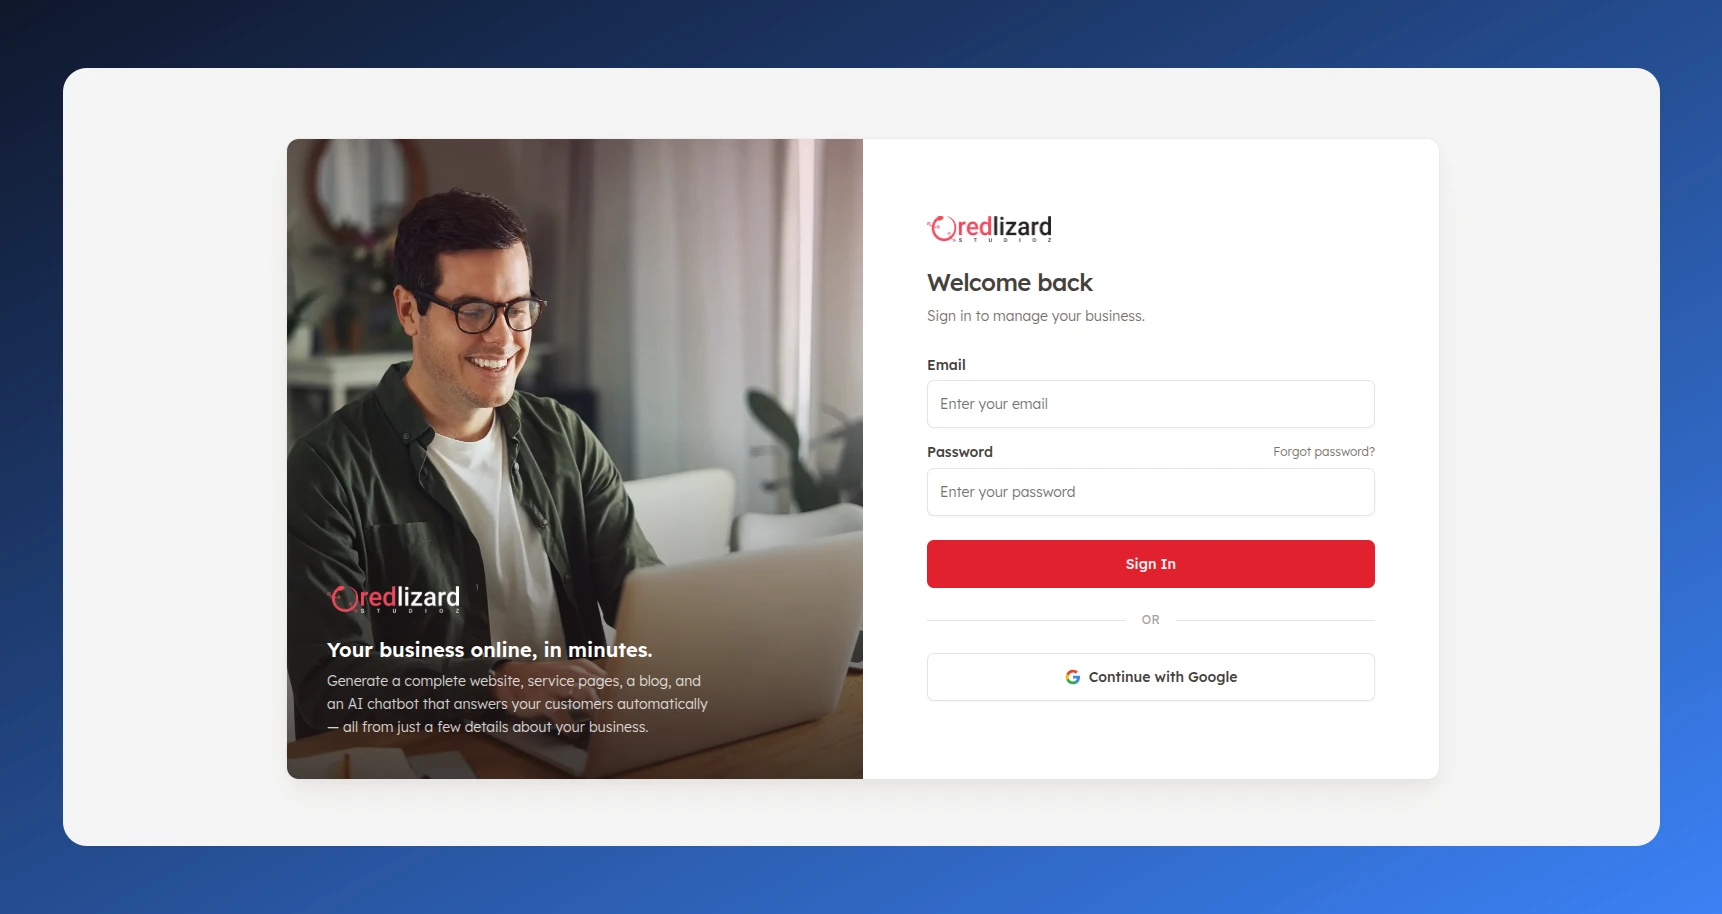
- Flujos de autenticación: inicio de sesión, registro, Google OAuth, olvido y restablecimiento de contraseña.
- Un flujo de entrevista público que se responde desde un link de invitación sin cuenta, excluido de la indexación en buscadores.
Integraciones
- Seis proveedores de LLM detrás de una única interfaz, con una acción de prueba de conexión en el dashboard.
- Email transaccional con Postmark para notificaciones de leads, resúmenes diarios, restablecimiento de contraseña e invitaciones a entrevistas.
- Obtención de noticias para ideas de contenido, más registros de integración para analytics, Search Console y agenda, con estado de conexión derivado.
- Un widget de chat embebible instalable en sitios web externos que no son tenants.
Entregables de ingeniería
- 111 suites de tests entre ambos repositorios, incluida una suite contra la API en vivo para el comportamiento que los stubs offline no pueden verificar.
- Pipelines de CI que controlan ambas aplicaciones, con runbooks de despliegue documentados en el repositorio.
- Un registro documentado de problemas conocidos con la causa raíz y la verificación de cada defecto resuelto.